Wie AI Software Engineering verändert
TL;DR: Mein Sohn fragte mich vor ein paar Tagen, wie AI beim Programmieren eigentlich funktioniert und warum das jetzt so ein Hype ist. Die Frage zu beantworten ist gar nicht so einfach. Es spielen eine ganze Menge an Entwicklungen der letzten Jahre mit ein, die ein LLM so wahnsinnig gut gemacht haben, besonders in der Entwicklung von Software. Doch ein LLM alleine hat noch nicht zum Durchbruch geführt: Erst die Kombination aus AI und intelligentem Tooling bringt ganz neue Möglichkeiten.
Erst mal verstehen viele unter AI
ganz unterschiedliche Dinge. Eine AI
oder KI
ist im Grunde ein System, das aufgrund von Mustererkennung Entscheidungen treffen kann. Die Erkennung der Muster basiert auf dem Training von zuvor erlernten
Daten. Davon haben wir seit vielen Jahren einige: Spam-Filter erkennen sehr gut, wie wahrscheinlich eine E-Mail Spam ist, jedes neuere Auto erkennt mittlerweile Straßenschilder (auch während der Fahrt und bei Regen) oder Stimmenerkennung bei Alexa und Siri. Alle haben gemeinsam, dass sie zuvor mit einer gigantischen Menge an Trainingsdaten trainiert
wurden. Wie das mit einem neuronalen Netz funktioniert, habe ich vor ziemlich genau 10 Jahren hier schon mal gezeigt.
Ein LLM (Large Language Model) funktioniert ähnlich: Es ist ein neuronales Netz, das auf einer gigantisch großen Menge von Text trainiert wurde, um Muster in Texten zu erkennen und semantisch ähnliche Dinge nah zueinander anzuordnen. Die meisten Frontier-Modelle sind so universell, dass sie die komplette Sprache (oder mehrere Sprachen) abbilden. Gibt man dem LLM eine Eingabe (Prompt), wird errechnet, welches Wort (~Token) am wahrscheinlichsten darauf folgt. Das Modell kann man sich als große Landkarte vorstellen, auf der ähnliche Dinge (Embeddings) näher beieinander sind. Das Training optimiert nur die Positionen der Dinge auf der Karte und somit die Vorhersage des nächsten Tokens. (Wer es genau wissen will, dem sei der Artikel How LLMs Actually Work von 0xkato empfohlen)
Das Konzept lässt sich auch ausgezeichnet auf Programmiersprachen anwenden. Trainingsmaterial gibt es dank Open Source und Github in fast unendlicher Menge. Doch will man Programmcode durch ein LLM erraten
lassen, geht das nicht so einfach wie bei Texten. Ein Zeichen Falsch: Syntaxfehler oder noch schlimmer: Logikfehler. Hier braucht es noch weitere Unterstützung von außen, sodass es das LLM einfacher hat, die nächsten Tokens so zu wählen, dass sie auch korrekten Code repräsentieren. GitHub Copilot hat das schon vor Jahren bewiesen, dass das geht: Die smarte Code-Vervollständigung in der IDE beim Schreiben von Code war ein Game-Changer. Aber hier hatte das LLM den perfekten Kontext. Dieser fehlt einem universellen LLM wie Kimi oder Opus. Deshalb sind ein paar Hilfen notwendig, um die es in diesem Artikel gehen soll.
LLM Capabilities
Die verschiedenen Modelle haben verschiedene Features (Capabilities), je nachdem, womit und wie sie trainiert wurden. Die großen Frontier-Modelle sind universell und decken viele Sprachen und Features auf einmal ab. Es gibt aber auch Modelle, die sehr speziell für einen Anwendungsfall trainiert sind und so nur eingeschränkte Möglichkeiten haben.
Reasoning, Thinking, Chain of Thought
Eine komplexe Fragestellung lässt sich oft nicht direkt mit einem einfachen Ja
oder Nein
beantworten. Und auch wenn die ultimative Antwort darauf hinausläuft, müssen verschiedene Optionen abgewogen, etwas durchdacht
und Schlüsse daraus gezogen werden. Diesen Denkprozess, den wir als Menschen bei so gut wie allem fast unterbewusst machen, ist das Reasoning
in einem LLM. Das Problem wird in kleine Teilaufgaben verlegt (Requestanalyse) und jedes dieser Teilprobleme wird dann separat beackert. Im Anschluss werden dann die Teilergebnisse zusammengefasst, abgewogen und evtl. ergeben sich weitere Teilprobleme. In LMStudio kann man diesen Denkprozess
live mitverfolgen.
Kommt das Reasoning an einen Punkt, an dem zwei oder mehrere Optionen gleichwertig oder komplett konträr sind, wird auch der User einbezogen und kann eine Entscheidung treffen. Claude Code nutzt dies regelmäßig.
Wie intensiv das LLM Reasoning betreibt, lässt sich bei den meisten Modellen mit einer Variante
einstellen. Oft mit low, high oder maxbetitelt. Bei low wird nicht sehr viel Reasoning betrieben, das ist schnell und spart Kosten. Doch wirklich Sinn macht das nur bei einfachen Tasks. In der max-Variante ist die Denk-Tiefe
unlimitiert und das Ergebnis ist besser, dauert aber länger und kostet entsprechend mehr. Auch hier gilt es, die richtige Einstellung für die aktuelle Fragestellung zu wählen.
Vision
Ein LLM kann nicht nur mit Text umgehen. Ist sie auch mit Bildern trainiert, können auch Bilder erkannt und generiert werden. Das ist extrem hilfreich, um dem LLM Screenshots von Fehlermeldungen, Website-Layouts oder zum Verstehen von GUI-Anwendungen zu ermöglichen. Umgekehrt können so Sequenzdiagramme aus Code oder Anpassungen an bestehenden Bildern vorgenommen werden.
Tool Use
Zentral für die Nützlichkeit von LLMs beim Programmieren ist die Möglichkeit, Werkzeuge aufzurufen, die zuvor bereitgestellt wurden. Schon mit ganz primitiven Tools wie read_file oder call_command kann Kontext aufgebaut werden, ohne dass der User diesen explizit liefern muss. Gerade unter Linux und OSX ermöglicht das ein ganzes Spektrum von zusätzlicher Funktionalität und situatives Einleiten
von Kontext. Unix-Tools wie grep, cat, ls, find und sed, auf die mit call_command zugegriffen werden kann, ermöglichen dem LLM so, sich auf dem Dateisystem umzusehen, nach Dateien zu suchen, Dateiinhalte anzusehen und sie auch gezielt zu verändern. Aber auch zur Selbstverifizierung der Antwort spielt die Möglichkeit, Werkzeuge aufzurufen, eine entscheidende Rolle: Code kann compiliert werden, Unit-Tests können automatisiert laufen oder API-Endpunkte können aktiv aufgerufen werden, um die Response zu prüfen. Die Möglichkeiten sind hier endlos. Projekte wie OpenClaw nutzen dies exzessiv.
Harness, Agent, Agentic Coding
Um diese Capabilities eines (oder mehrerer) LLMs zu nutzen, benötigt es eine Plattform, die die Koordination zwischen den LLMs, dem Kontext, den Tool-Calls und weiteren Quellen durch MCP-Server verbindet. Dies wird als Harness
bezeichnet (auch manchmal Coding Agent bezeichnet). Ein Harness ist die technische Infrastruktur, die einen Agent ausführt und kontrolliert. OpenCode, Pi oder auch Claude Code sind gern benutzte Coding Agents. Aber auch in vielen IDEs ist ein Coding Agent eingebaut, der das Gleiche macht.
Coding Agent
deshalb, da das Konzept der Agentic AI auch in vielen anderen Bereichen verwendet wird, um LLMs eine Infrastruktur zu bieten. So kann ein Agent verschiedene spezifische Aufgaben übernehmen, die für seine Domäne optimiert sind. Coding Agents sind spezialisiert darauf, effizient große Mengen von Code zu analysieren, neue Features zu planen, in Tasks einzuteilen und sich selbst zu verifizieren.
Der Vollständigkeit halber und um Verwirrungen auszuschließen: Als Agentic Coding
ist das Arbeiten mit Coding Agenten gemeint, also die Interaktion von User und Coding Agent.
Doch was macht ein Coding Agent aus, dass er so unglaublich gut und effektiv ist, Code zu schreiben?
Tool Calls
Zuerst natürlich die Möglichkeit, Tools auszuführen. Bei Bedarf kann die AI sich erforderlichen Kontext selbst besorgen, Änderungen an Programmcode und Konfiguration vornehmen und das Ergebnis gegenprüfen.
MCP Server
Spezialisierte Tools lassen sich mit MCP-Servern nachrüsten
. Ein solcher Server stellt die Schnittstelle zwischen dem Coding Agent und einem externen System her. Das kann eine lokale Anwendung wie Blender oder KiCAD sein, oder eine API eines Warenwirtschaftssystems. Damit kann nun die AI über einen standardisierten Weg beim Erstellen von 3D-Modellen helfen oder Logikfehler in Elektronik-Schaltplänen finden.
IDE-Features als Tool-Calls
Language Server (kurz LSP) hat sich in den vergangenen Jahren zum Standard etabliert. Die Idee dabei: Editor und Programmiersprache voneinander trennen. Ursprünglich musste jeder Code-Editor und jede IDE für jede unterstützte Programmiersprache deren Semantik verstehen und implementieren, damit Funktionen wie Springe zur Definition
oder allgemein Code-Completion möglich waren. Nun übernimmt der LSP-Server diese Aufgabe und die IDE muss sich nur noch um die Anzeige kümmern.
Ein Coding Agent kann sich das auch zunutze machen und statt sich durch die Dateien mit grep zu wühlen, den Code gezielt auf semantischer Ebene durchforsten. Serena ist ein solches Tool, das IDE-Features in den Coding Agent bringt.
Skills
Ein weiterer beliebter Weg, um den Kontext mit nützlichen Informationen anzureichern, sind Skills. Das sind einfache Textdateien, die Workflows, Regeln, Anweisungen oder Domainwissen enthalten. Der Inhalt dieser Dateien wird dann zusammen mit dem eigentlichen Prompt an das LLM geschickt. Ein Skill könnte beispielsweise beschreiben, wie Git Commits zu formulieren und zu formatieren sind, dass alle Commits signiert werden sollen und vor jedem push der User um Erlaubnis gefragt werden muss.
Selbstkorrektur durch Software Engineering Praktiken
Die Best Practices
beim Software Engineering, speziell der testgetriebenen Entwicklung, machen sich auch Coding Agents immer mehr zunutze: So definiert die AI zuerst den Soll-Zustand in Form eines UnitTests oder eines kleinen Scripts und nutzt dies, um die eigene Implementierung zu verifizieren. Diese Möglichkeit der Selbstkorrektur hilft extrem. Einerseits der AI um so lange Korrekturschleifen zu fahren, bis das korrekte Ergebnis erreicht ist, ohne den User zu fragen. Andererseits hilft es dem User, mehr Vertrauen in den generierten Code zu bekommen und besser nachvollziehen zu können, was die Änderungen machen.
Lernende Agenten
Systeme wie Hermes speichern erlerntes Wissen und Fakten in einer persistenten Datenbank, um später bei Bedarf wieder darauf zuzugreifen. Ein persönlicher Assistent, der mitlernt. Aber auch Claude Code hat mit Memory Files ein ähnliches Feature im Angebot.
Kontext
Soviel zur Begriffserklärung. Das wirklich Entscheidende ist allerdings der Kontext, auf dessen Basis die Antwort vom LLM formuliert wird. Hier gibt es einerseits extreme Limitierung in Form von Platz, andererseits viele Möglichkeiten, den Kontext mit nützlichem Inhalt zu füllen. Wie groß dieser Kontext ist, hängt vom Modell ab. Moderne LLMs sind in der Lage, einen großen/langen Kontext zu halten, doch das ist nicht immer sinnvoll.
Kontext Engineering
Was ist das eigentlich konkret? Der Kontext ist praktisch der gesamte Request, der einem LLM für die Errechnung der Antwort mitgegeben wird. Wird ein Prompt in einem Coding Agent eingegeben, wird diesem der Kontext vorangestellt. Kontext + Prompt wird dann an das LLM geschickt und die Response wird angezeigt.
Wie sich der Kontext zusammensetzt, bestimmt zum einen Teil der Coding-Agent, zum anderen der LLM-Anbieter.
- System-Kontext: Die LLM-Anbieter stellen einen geheimen und nicht änderbaren Kontext bereit, der sicherstellen soll, dass das Modell nicht für schädliche oder illegale Dinge verwendet werden kann.
- Tool-Bibliothek: Alle Tools, die dem LLM zur Verfügung stehen. Dies ist eine simple Liste von Funktionsnamen, deren Parametern und einer kleinen Beschreibung, wofür das Tool verwendet werden kann. Die Tools kommen zum einen vom Codding Agent, zum anderen von den geladenen MCP-Servern.
- Geladene Skills: Der User kann Skills (simple Textdateien mit Anweisungen) definieren, die Sachverhalte erklären, Workflows definieren oder beschreiben, wie das LLM sich verhalten soll. Hierbei wird aber nur der
Header
des Skills (Name und Beschreibung) dem Kontext hinzugefügt. Der Agent entscheidet dann anhand des vorherigen Prompts, ob ein oder mehrere Skills komplett geladen werden oder nicht. - Verlauf: Der komplette Verlauf aller Prompts und Antworten seit Beginn der Session.
- Prompt: Der eigentliche Prompt, den der User eingibt.
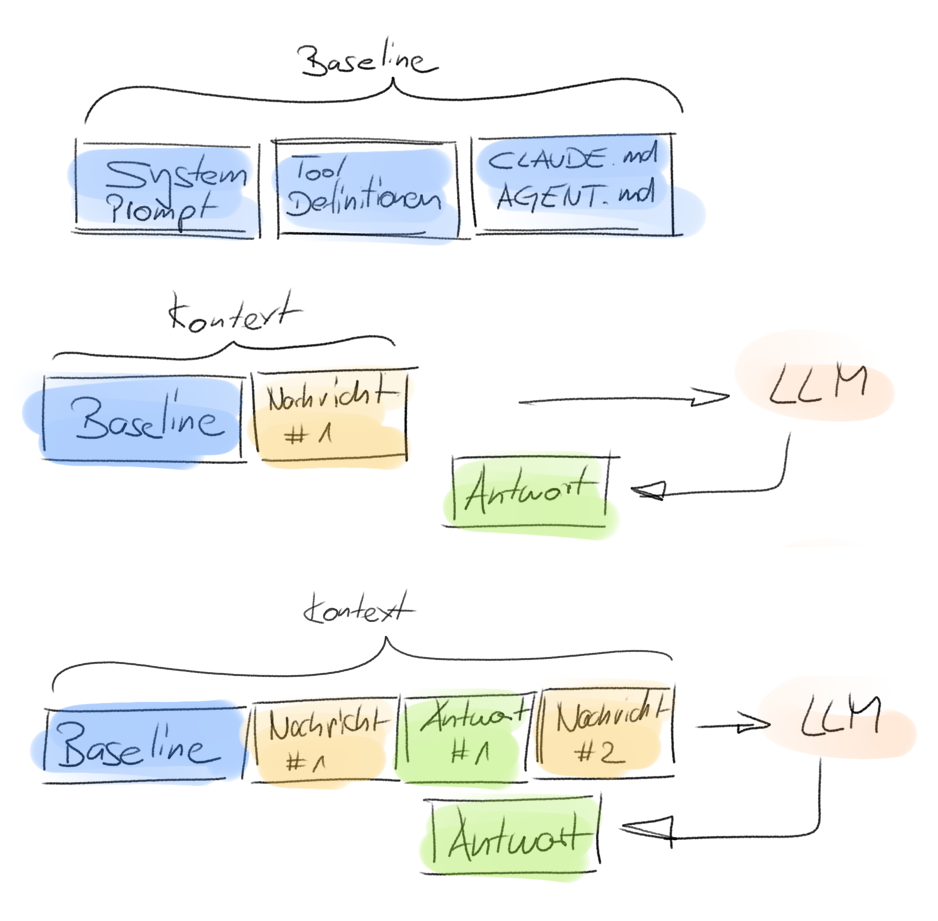
All diese Komponenten werden zu einem Request zusammengefasst und an das LLM geschickt. Request und Response sind hier komplett zustandslos! Der Coding Agent behält den Zustand (Prompt/Antwort-Historie) und schickt diesen bei jedem Request mit. Das hat den Vorteil, dass man das LLM-Modell auch während der Session austauschen kann. Im Umkehrschluss heißt das allerdings auch, dass der Kontext immer größer wird, je länger die Session läuft. Und dass der User selbst für das Management des Kontexts verantwortlich ist.
Und hier kommen die Tokens ins Spiel: Jede Subscription eines LLM-Anbieters stellt dem User entweder ein Kontingent von Token in einem zeitlichen Rahmen zur Verfügung, oder es wird per Token abgerechnet. Ein Token entspricht grob einer Silbe eines Wortes (hängt vom Modell ab), und so ergibt sich dann auch die Anzahl an Tokens, die verbraucht
werden.
Doch nicht jeder Token kostet gleich viel. Es gibt grob vier verschiedene Preise (abseits der Wahl des Modells):
- Input Token: Dazu zählt alles NEUE, das dem LLM geschickt wird. Der erste Request in einer Session ist also teuer, da alles neu ist.
- Cache Write: Jede Session bekommt einen Cache, der bereits bekannte Requests speichert.
- Cache Read/Hits: Eine Session besteht meist nicht nur aus einem einzigen Request und Response, sondern aus einer Konversation. Hierbei ist der Präfix (vorzugsweise) immer gleich (Systemprompt, Skills, usw.), nur die einzelnen Prompts und Antworten stapeln sich. Der Präfix, der zuvor durch einen Cache Write gespeichert wurde, kostet nur noch einen Bruchteil.
- Output Token: Alles, was das LLM als Antwort liefert. Dies sind meist die teuersten Tokens.
Es lohnt sich also darauf zu achten, dass der Kontext klein bleibt (nicht nur für die Kosten, auch die Qualität der Antwort wird besser) und sich der Präfix möglichst nicht ändert, um den Cache optimal zu nutzen. Also nicht ständig MCP-Server und Skills aktivieren/deaktivieren. Zu viel Kontext gibt dem LLM zu viel Freiraum und die Antwort kann in die falsche Richtung abdriften.
Optimierung
Es gibt ein paar weitere Möglichkeiten, den Kontext sauber
zu halten. Die einfachste Variante ist die Kompression bzw. Compaction: Hierbei wird der Kontext (wieder mithilfe eines LLMs) zusammengefasst, sodass nur noch die relevanten Dinge kurz und kompakt enthalten sind. Das zerstört natürlich einen Teil des Caches, doch es macht die Qualität der darauffolgenden Antworten besser und den Kontext kleiner und spezifischer. Die meisten Coding Agents haben dafür eine Funktion oder machen dies sogar automatisch, sollte der Kontext zu groß werden.
Subagents
Coding Agents haben ein Feature, bei dem größere Tasks (Recherchearbeiten, Testing etc.) in einem separaten Kontext ausgeführt werden können, um dann nur noch das Ergebnis zurück in den Hauptkontext zu schieben. Auch praktisch hier: Der Subagent kann dann ein anderes LLM verwenden, das speziell für diesen Task konzipiert ist oder schlicht billiger ist. In OpenCode gibt es hier zudem noch verschiedene Möglichkeiten, das LLM zu konfigurieren (Temperatur, Variante), Berechtigungen einzuschränken oder die maximale Anzahl an Reasoning-Schritten zu definieren.
Headroom
Eine noch smartere Lösung ist ein Proxy, der zwischen dem Coding Agent und dem LLM sitzt und die Requests optimiert. Mit Headroom habe ich sehr gute Erfahrungen gemacht. So wird dem Request unnötiger Overhead entzogen, bevor er dem LLM übergeben wird. Damit lassen sich ca. 20% der Tokens einsparen.
Caveman
Auch sehr nützlich ist Caveman, ein Skill der das LLM anweist, so kurz und knapp wie möglich zu antworten, um teure Output-Tokens zu sparen.
Fazit
Es ist nicht nur das reine LLM-Modell, das immer besser wird, es ist auch das intelligente Zusammenspiel von Tools und Optimierungen, die dem Prompt die optimale Ausgangslage und den bestmöglichen Kontext bieten, um eine spezifische Antwort auf eine spezifische Frage zu liefern. Je präziser der Prompt ist, desto besser die Response vom Modell. Baut man dann noch Korrekturschleifen ein (UnitTests, Gegenchecks per Tool-Call, Referenz zum Abgleich), kann auch ein Ralph-Loop erfolgreich sein. Ob das die Zukunft des Software Engineering ist, wird sich allerdings noch zeigen.